歌曲生成
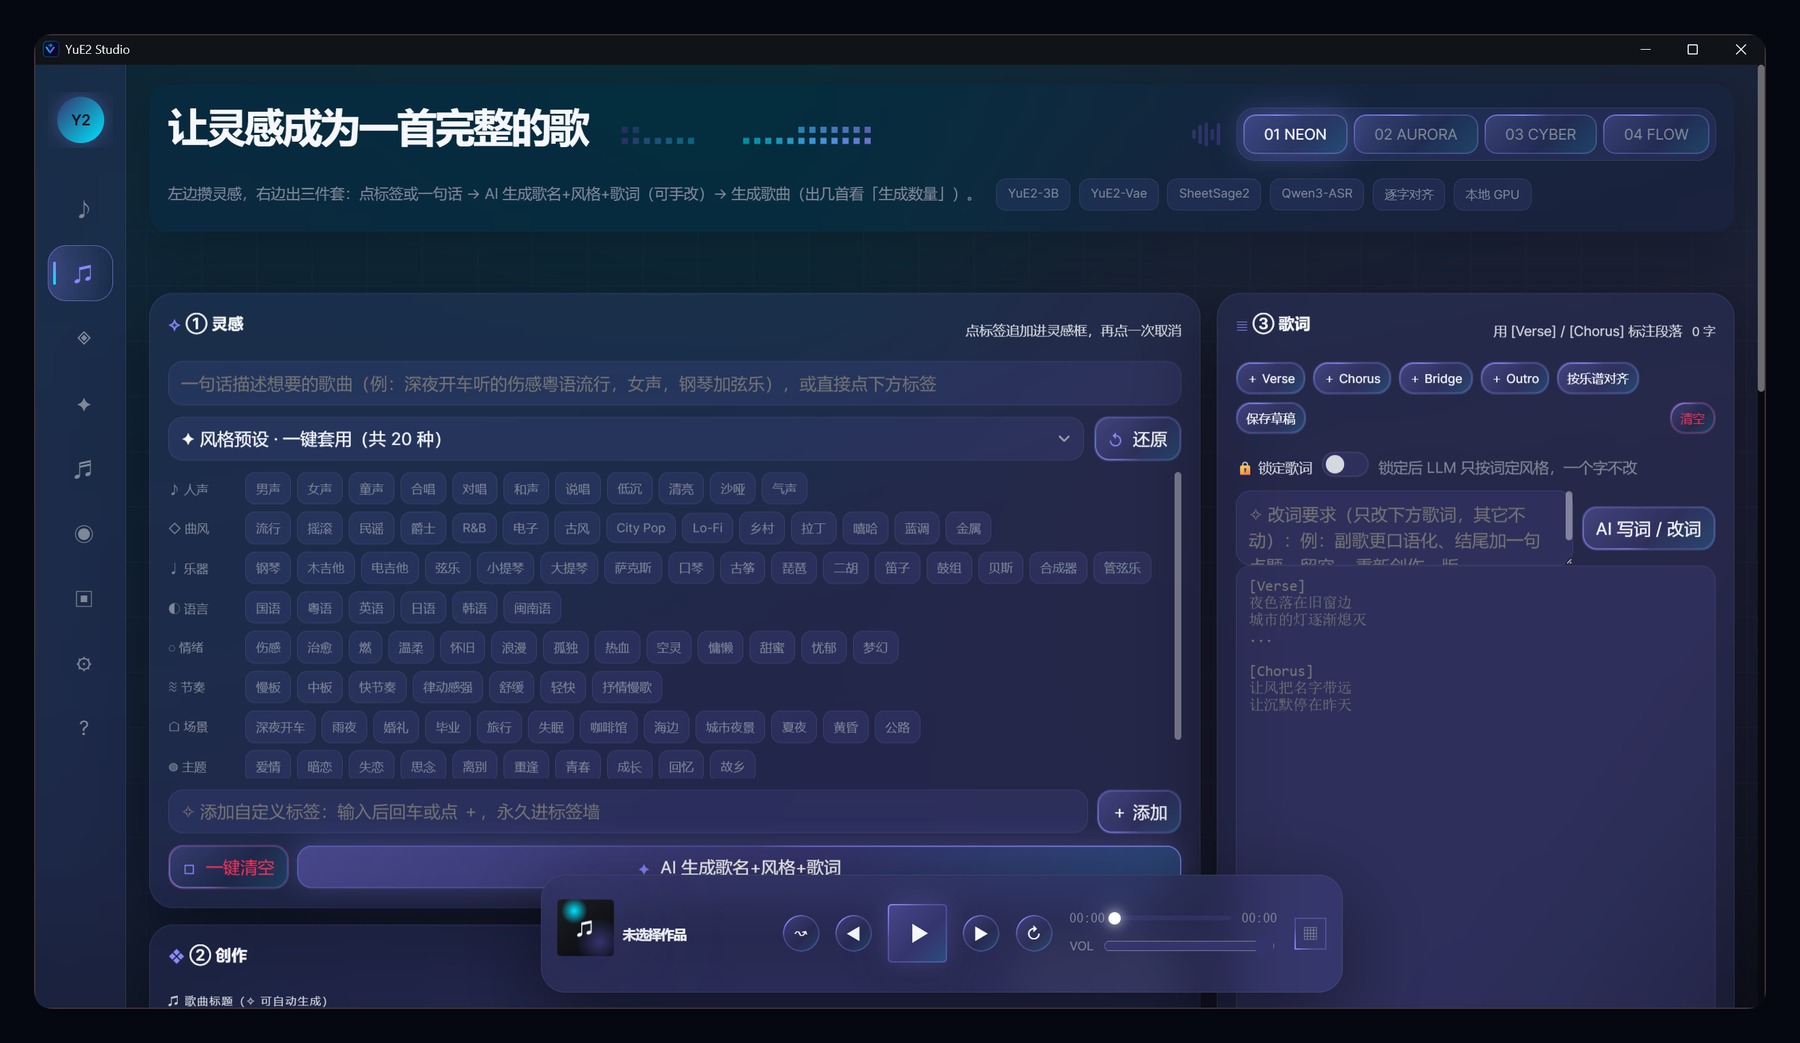
从一句词开始,歌名、风格、歌词一起出来,都能手改。写完词只想谱曲也行。一次能出几个版本,听着挑,挑剩的删掉。
一个跑在我自己电脑上的东西。
最早只是想把手里的词变成能听的歌。后来一件事接一件事往里加——写词、生成、换声、分轨、字幕、封面,原本要在几个软件之间来回倒的活,现在一个界面就能从头走到尾。
她不在云上,也不用排队。模型、算力、文件都在本机,断网也能跑完一首歌;做完的东西直接落进硬盘里的一个文件夹,不经过任何人的服务器。
都是自己做出来的。点封面就能听——压过一遍的预览音质,够听出门道。
从一句词开始,到能发出去的成品,
中间所有工序都在这台电脑上完成。
从一句词开始,歌名、风格、歌词一起出来,都能手改。写完词只想谱曲也行。一次能出几个版本,听着挑,挑剩的删掉。
挑一首歌,给一段参考音色。她先听一遍两边,自己算融合、混响、EQ,再分块换声、混回来。长曲子也不会一段响一段轻。
歌出来,字幕一起对好了。一句一句对到字,播放时跟着染色。字幕、乐谱、无损音频,一次落进同一个文件夹。
扒词、扒谱、逐字对齐、分成 4 轨或 6 轨。翻唱和二次创作要用的,都在这里。跑的全是本地的模型。
词或谱不顺,不用整首回炉。挑一首自己的作品、或者传一首歌进来,先扒出词和谱,让模型改,改完再生成一遍。
按歌的意思写封面描述,本地出图,再写进音频文件的封面块里。出图靠本机跑的 ComfyUI,不经过我的服务器。
整屏听歌。封面铺满,歌词浮在上头,唱到哪亮到哪。想安静听一遍的时候,用她。
做过的东西都收在库里。改名、收藏、搜,两首摆一起 A/B 对比。想发给谁,可以打成一个包。
把一首歌拆成六轨,人声、鼓、贝斯、吉他、钢琴、其他,一轨一轨调音量、换乐器。这块还没做完,先留着。
模型在这台机器上跑,作品在这块硬盘里存。不用等额度,不用排队,也不用把还没成形的想法交给谁。
看看最近改了什么 ↓写下来只是开头。剩下的,是一遍一遍听、一遍一遍改,直到自己也挑不出毛病。
想到一句词,或者一段旋律,先写下来。哪怕只有半句。
挑方向、生成、改。不满意就重来,一遍一遍听到顺耳为止。
对字幕、配封面、导出。自己听着过得去,才放到外面。